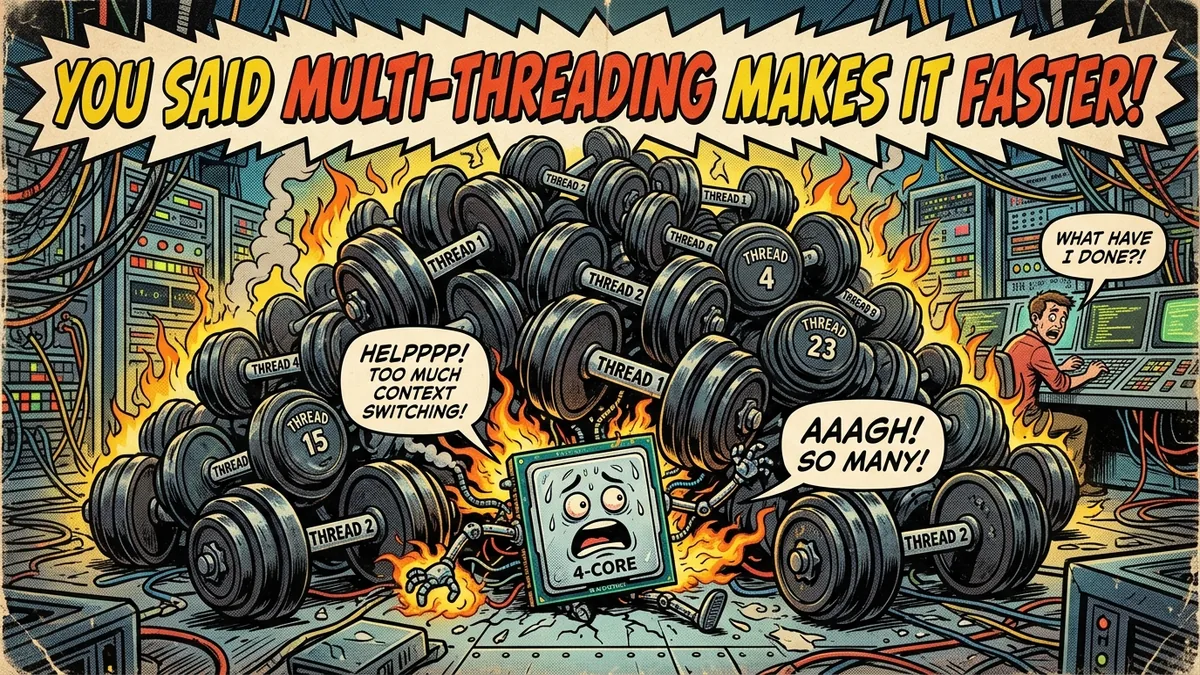
簡單來說,Thread (執行緒) 是由作業系統 (OS) 來管理和調度的,而 Coroutine (協程) 的控制權則在我們開發者手上,由程式語言的執行環境 (Runtime) 在使用者層級進行調度。這個根本性的不同,導致了它們在資源消耗和效能上有著天壤之別。
成本和適用場景
Thread 是『重量級』。Preemptive multitasking managed by the OS.
每建立一個 Thread,OS 都需要為它分配獨立的、MB 等級的記憶體堆疊。更致命的是它的『上下文切換』成本。當 OS 決定從 Thread A 切換到 Thread B 時,需要深入核心模式 (Kernel Mode),保存 A 的所有現場(CPU 暫存器、完整堆疊等),再載入 B 的現場。這整個過程非常耗時,是微秒 (µs) 等級的。
-
重量級 (Heavyweight): 建立和管理Thread可能相當耗費資源。
-
阻塞 (Blocking): Thread可能會互相阻塞,特別是當它們在等待資源或 I/O 操作時。
-
上下文切換 (Context Switching): 在Thread之間切換需要儲存和載入它們的狀態,這可能會很耗費成本。
-
由作業系統管理 (OS Managed): Thread 由作業系統管理,這可能會增加額外開銷。
Coroutine 是輕量級 Cooperative multitasking
它活在 Thread 內部,像是一種合作關係。建立一個 Coroutine 的成本極低,只佔用 KB 等級的記憶體。它的切換,是程式自己決定的,通常在await這種等待 I/O 的地方,主動讓出執行權。這個切換完全在使用者模式 (User Mode) 內部完成,就像一次函式呼叫,成本是奈秒 (ns) 等級的,比 Thread 切換快了上千倍。
-
輕量級 (Lightweight): Coroutine比Thread輕得多;你可以建立數千個Coroutine而不會有顯著的開銷。
-
非阻塞 (Non-Blocking): Coroutine使用暫停函式 (suspending functions) 來讓出控制權而不阻塞執行緒,從而有效利用資源。
-
較少開銷 (Less Overhead): 與Thread相比,Coroutine之間的上下文切換更快且資源消耗更少。
-
由開發者控制 (Controlled by Developer): Coroutine提供了對任務執行的更精細控制。
適用場景:別再為 CPU 密集任務隨意 new Thread
很多人在早期 Java 時代形成了一種直覺:「I/O 阻塞用協程,CPU 算力榨汁用 Thread」。
但在現代 Android ART 與 Linux 排程器視角下,這個認知需要精準拆解為三個階梯:
1. 純 Kotlin / Java 演算法:首選 Dispatchers.Default
如果你在純 Kotlin 裡跑大矩陣計算、深度 JSON 反序列化,千萬不要自己手動 new Thread!
每開一條 Java Thread 都會吞噬 1MB 虛擬線程棧;當線程數超過 CPU 核心數,Linux CFS 排程器會發動頻繁的時間片搶佔,洗刷 L1/L2 快取(Cache Thrashing),算力全浪費在 Context Switch 上。Dispatchers.Default 底層是 Work-Stealing 線程池,把活躍線程鎖死在 CPU 實體核心數,保證 CPU 流水線永遠吃飽且 Context Switch 趨近於零:
suspend fun parseMassiveDataset(rawBytes: ByteArray): ProcessedResult =
    withContext(Dispatchers.Default) {
        // 迴圈中配合 ensureActive() 支援合作式取消,避免孤魂線程狂燒 CPU
        ensureActive()
        heavyCalculationCore(rawBytes)
    }
2. JNI 密集計算與 C++ 硬體綁核:專屬 Dedicated Thread
什麼時候才輪到 Thread 出場?當任務牽涉長時間的 C++ Native 運算時。
若一段耗時 500ms 的影像演算法直接丟進 Dispatchers.Default,在 4 核心(如高通 QM215)弱板子上,4 個任務同時進來就會引發「全域協程池飢餓(Starvation)」,主線程與其他輕量協程全部卡死。
此時必須使用獨立專屬的線程池,並在 Native 端調用 pthread_setaffinity_np 將線程死死釘在實體大核上,防止跨核心漂移導致快取失效。
3. 高併發 I/O 密集型任務:Coroutine 的絕對主場
Web 請求、本地 SQLite / Room 讀寫、資料庫連線,99% 的時間都在等網路或磁碟 I/O,這時 Coroutine 能用微秒級的代價在掛起點主動讓出 CPU,以極低開銷支撐成千上萬的任務並發。
發佈留言